Puse a prueba a Laya, el modelo "System 1" viral de 421M, contra las finanzas de mi familia. Perdió 18 a 2.
Un experimento honesto con el modelo de decisiones open-source del que todos hablan — desplegado en mi propio servidor, medido contra datos reales, sin cherry-picking.
El hype
Esta semana mi feed explotó con Laya: un modelo de decisiones no-autoregresivo de Convai Innovations, open-source (Apache 2.0), 421 millones de parámetros, que promete responder preguntas estructuradas en ~33 ms sin generar texto. La comparación contra Jev de TypeSafe AI — 7.8× más rápido, gratis, self-hosteable — lo convirtió en la historia de la semana.
La premisa es seductora: "no todo problema de IA necesita un chatbot autoregresivo". Para clasificación, routing y guardrails, un encoder bidireccional que devuelve probabilidades calibradas en una sola pasada suena como la herramienta correcta.
Pero había un detalle enterrado en la propia documentación del autor que casi nadie citó:
"Laya es una base rápida para especializar, no un motor de decisiones zero-shot."
Yo tenía el banco de pruebas perfecto para verificar esa frase. Este es el resultado.
El caso de uso: mi centro de control financiero familiar
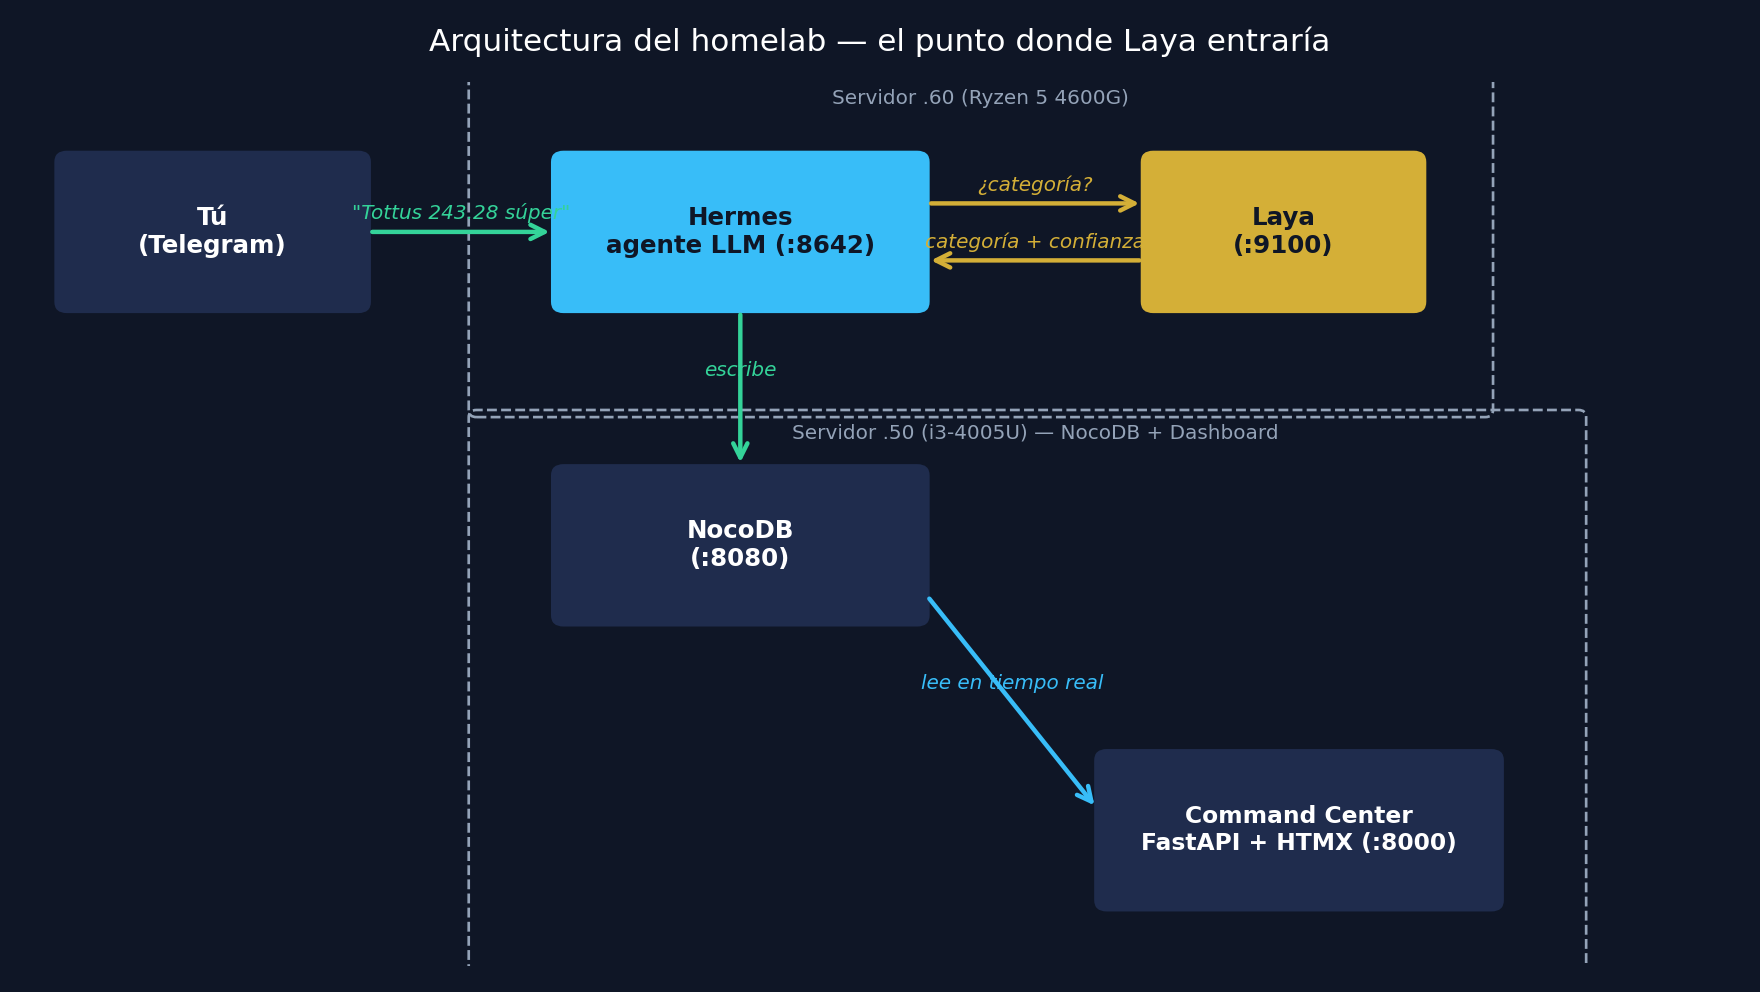
Tengo un homelab con dos servidores en mi red local donde corre un sistema que llamamos Family Wealth Command Center: un dashboard FastAPI + HTMX que consume en tiempo real una base NocoDB con las finanzas de mi familia — 85 transacciones, 56 categorías personalizadas en español (de "Supermercado Semanal / Despensa" a "Talleres / Extracurriculares Hijas"), 12 dimensiones, cuentas en dos monedas.
Además, un agente de IA llamado Hermes (NousResearch hermes-agent) corre en el segundo servidor: le escribo por Telegram "Tottus 243.28 súper de la semana" y él registra el gasto en NocoDB.
El eslabón débil del sistema: la categorización. Hermes, como todo LLM, es creativo — un día pone "Comida", otro día "Restaurantes". Mi dashboard necesita consistencia taxonómica, no creatividad. Laya prometía exactamente eso: decisiones determinísticas contra una lista cerrada de opciones.
El experimento
Despliegue
Laya corre en un contenedor Docker en mi segundo servidor (Ryzen 5 4600G, 14 GB RAM, CPU-only). Un microservicio FastAPI propio expone un único endpoint POST /clasificar que recibe una transacción y devuelve dimensión + categoría + confianza calibrada. Las 56 categorías se sincronizan desde NocoDB al arrancar — si agrego una categoría nueva, el clasificador la aprende solo.
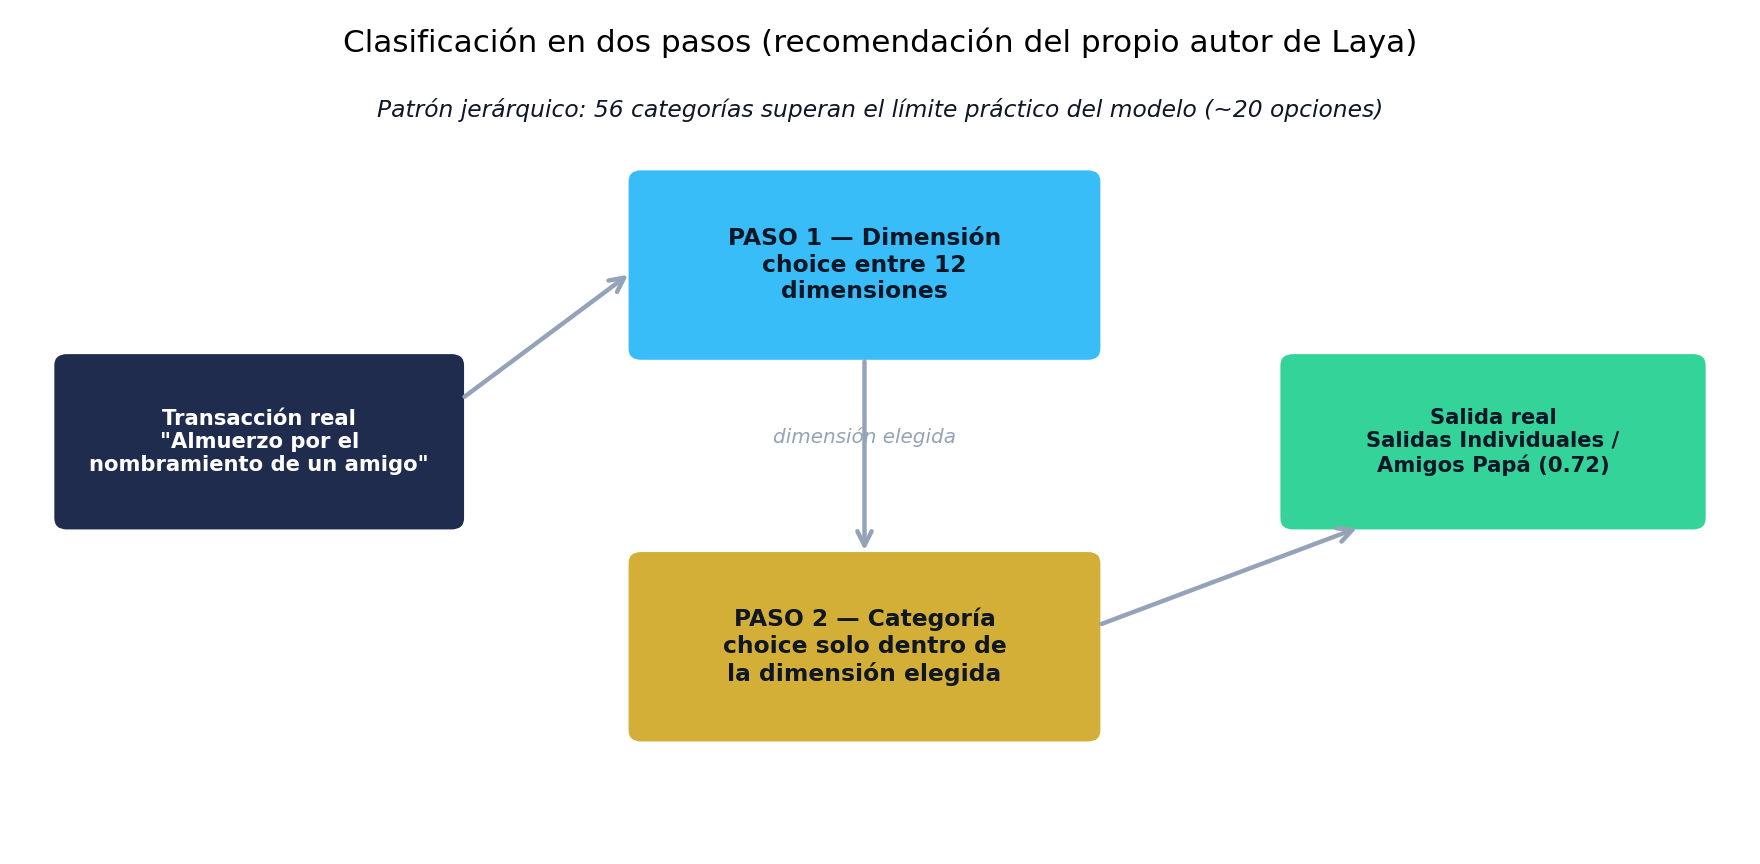
Como 56 opciones superan el límite práctico del modelo (~20 opciones por pregunta, según el propio autor), implementé el patrón jerárquico recomendado: primero decide la dimensión (12 opciones), luego la categoría dentro de esa dimensión.
La medición
Diseño simple y sin trampas: tomé 20 transacciones reales ya categorizadas por mí (el ground truth), se las pasé a Laya sin revelarle la categoría, y conté aciertos exactos.
Los resultados
| Configuración | Exactitud | Latencia promedio |
|---|---|---|
| Zero-shot puro | 10% (2/20) | ~900 ms (CPU) |
| Few-shot (ejemplos reales en los criterios) | 5% (1/20) | ~1000 ms (CPU) |
Diez por ciento. En una tarea donde elegir la dimensión al azar ya te da ~8%.
Los fallos son ilustrativos:
- "Compra de fruta" → predijo Delivery Comida Fin de Semana (real: Mercado de Frescos)
- "Entrada concierto Helloween" → predijo Matrícula Escolar & Cuotas APAFA (real: Cine, Eventos & Entretenimiento)
- "Cena en Siete Sopas" → predijo Cuidado Personal & Barbería Papá (real: Restaurantes & Salidas Familiares)
No son errores absurdos — el modelo entiende que una fruta es comida y que una cena es salir. Lo que no puede hacer es mapear eso a mi taxonomía específica, con mis comercios locales (Tottus, Pastipan, Siete Sopas), en español, con 56 opciones que jamás vio en entrenamiento.
El hallazgo inesperado: la calibración sí funciona
Aquí está lo que casi nadie está midiendo del modelo. Miren la confianza reportada:
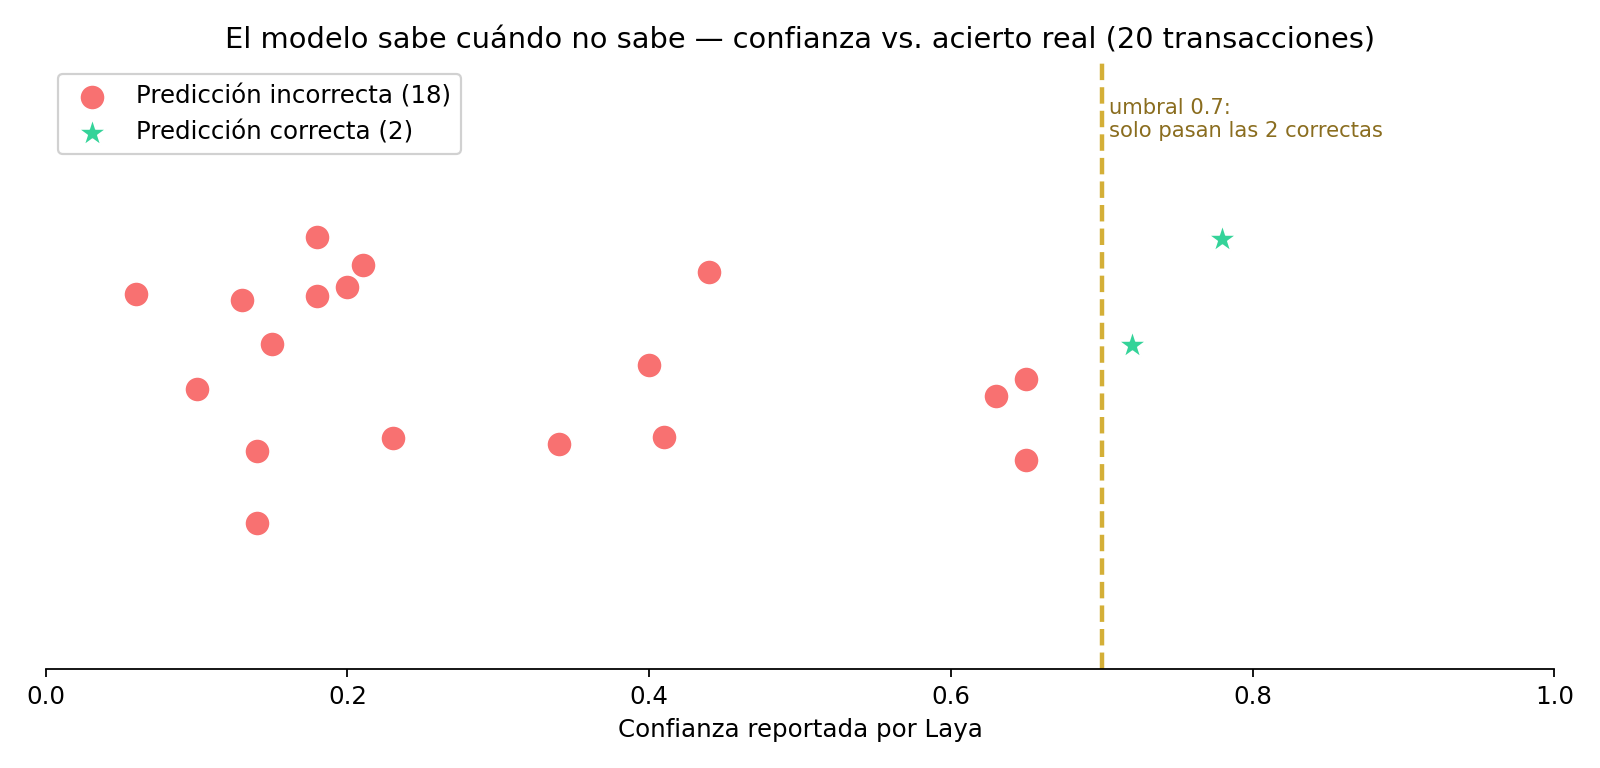
- Cuando acertó, reportó confianza de 0.72 y 0.78.
- Cuando falló, la confianza fue casi siempre < 0.65 (media de los fallos: ~0.3).
El entrenamiento RLCD (RL contra strictly proper scoring rules) logró lo que prometía: el modelo sabe cuándo no sabe. Un umbral de 0.7 habría filtrado casi todos los errores y escalado a un humano — que es exactamente el patrón "act-or-escalate" para el que fue diseñado. En producción, un clasificador que falla 90% pero lo admite es infinitamente más seguro que un LLM que falla 10% con confianza absoluta.
Por qué falló (y por qué no es culpa del modelo)
- Zero-shot ≠ lo que venden los titulares. El 0.766 de accuracy que circula es del checkpoint fine-tuneado en el train split de ese benchmark. Los checkpoints base puntúan ~0.35 en ese benchmark — cerca del azar. El autor lo dice explícitamente; el hype lo omitió.
- Mi taxonomía es out-of-distribution total. 56 categorías personalizadas en español, con ámbitos familiares ("Madres", "Hijas") que no existen en ningún corpus.
- El fine-tuning no era realista para mí (aún). Laya necesita decenas de ejemplos por categoría; tengo ~85 transacciones repartidas en 56 categorías — 1-2 ejemplos cada una. En unos meses, con más historial, será viable. Hoy no.
- Few-shot en los criterios no ayudó — al contrario, empeoró (5%). Los encoders de decisión no son LLMs: meter ejemplos en el texto del criterio diluye la señal en vez de guiarla.
Qué hice al final
Volví a la arquitectura correcta para mi volumen (unas pocas transacciones al día):
- Hermes (el LLM) sigue clasificando, pero ahora con la taxonomía cerrada de 56 categorías en su system prompt y la instrucción estricta de nunca inventar categorías fuera de la lista. Los LLMs son genuinamente buenos en clasificación zero-shot — esta es su tarea.
- Anti-duplicados con una simple consulta SQL-like a NocoDB antes de escribir. No necesita IA.
- Laya queda desplegado en el servidor. Cuando tenga suficiente historial para fine-tunearlo (o para el checkpoint
typed-decisions), tengo el microservicio listo y el script de benchmark para medir de nuevo.
Las lecciones
- Los benchmarks virales se miden en la distribución del benchmark. Tu problema real es otra distribución. Mide siempre contra tus datos, aunque sean 20 filas.
- "Open-source y 7.8× más rápido" no responde la pregunta correcta. La pregunta es: ¿qué accuracy tiene en mi tarea, sin entrenar?
- La calibración honesta es una feature, no un detalle. Es lo que más me impresionó del modelo y lo que menos se discute.
- Un resultado negativo bien medido ahorra meses. Una tarde de experimento me evitó integrar a producción un clasificador que habría degradado silenciosamente mis reportes financieros.
- System 1 y System 2 no compiten, se complementan. Para volumen alto con fine-tuning, Laya será la capa correcta. Para cinco gastos al día con taxonomía exótica, el LLM gana hoy.
El stack completo (FastAPI + NocoDB + Docker + Hermes) corre en dos servidores caseros en mi LAN. El microservicio de Laya, el script de benchmark y los resultados crudos están disponibles para quien quiera replicar el experimento. Si tú también probaste Laya contra un caso real, me encantaría leer tus números en los comentarios.